Supermicro SYS-822GS-NB3RT-01-G2: обзор AI-сервера с 8 NVIDIA B300
Разбираем Supermicro SYS-822GS-NB3RT-01-G2: восемь NVIDIA B300, 2,3 ТБ HBM3e, NVLink, два Intel Xeon и возможности сервера для LLM, обучения нейросетей и корпоративного AI.
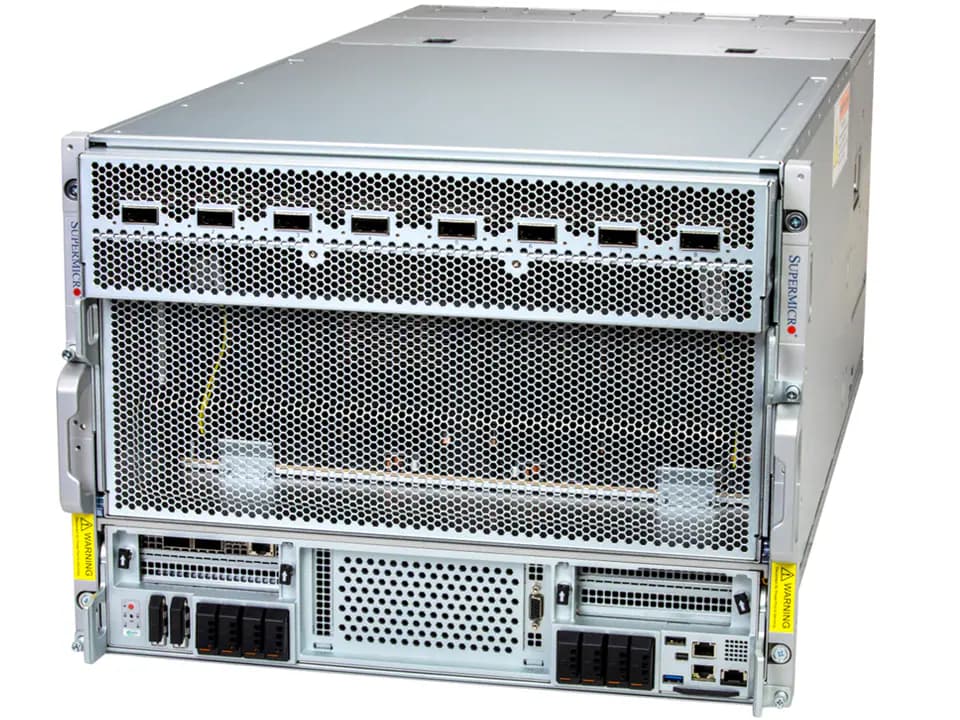
Supermicro SYS-822GS-NB3RT-01-G2 — не просто сервер с несколькими видеокартами, а готовая 8U-система семейства Gold Series на базе NVIDIA HGX B300. Внутри — восемь ускорителей Blackwell Ultra, два Intel Xeon 6768P и 2 ТБ оперативной памяти. Такая конфигурация ориентирована прежде всего на масштабный инференс больших языковых моделей (LLM), обучение и дообучение нейросетей, мультимодальный AI и вычислительные задачи, которые уже трудно эффективно обслуживать на обычных GPU-серверах.
Коротко: 8 × NVIDIA B300 с 288 ГБ HBM3e на ускоритель (2 304 ГБ суммарно по спецификации Supermicro), пятое поколение NVLink и NVSwitch, 128 физических CPU-ядер, 2 ТБ DDR5-6400 ECC и высокоскоростная сеть ConnectX-8. Главные вопросы перед покупкой — не только производительность, но и профили нагрузки, межсерверная сеть, потребление энергии, охлаждение и стоимость владения.
Что представляет собой Supermicro SYS-822GS-NB3RT-01-G2
Модель с полным индексом SYS-822GS-NB3RT-01-G2 — предварительно сконфигурированная система из семейства SYS-822GS-NB3RT. В отличие от barebone-платформы, здесь уже определены ключевые компоненты: два Intel Xeon 6768P по 64 ядра, восемь NVIDIA B300, 16 модулей DDR5-6400 RDIMM по 128 ГБ и загрузочный M.2 NVMe SSD на 960 ГБ. Конструкция предназначена для установки в стойку и обслуживания в инфраструктуре дата-центра.
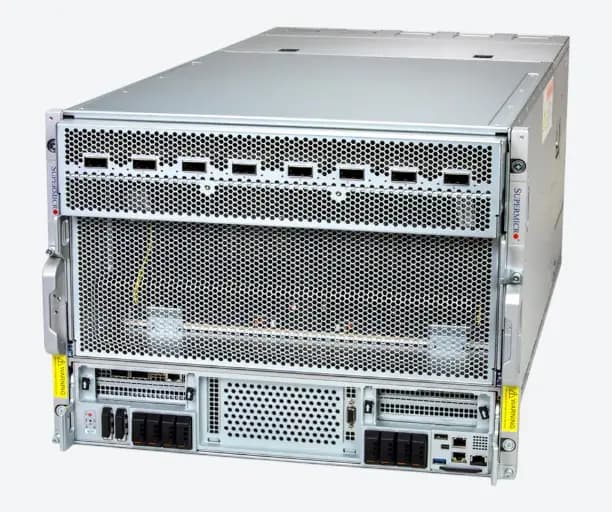
Внешний вид 8U-сервера Supermicro с платформой NVIDIA HGX B300: модуль с восемью GPU и отсеки NVMe.
Сценарии применения включают обслуживание генеративных моделей с большим количеством одновременных запросов, распределённый инференс, обучение нейронных сетей, научные расчёты и аналитические сервисы с интенсивным обменом данными. Но сам факт наличия восьми GPU ещё не определяет скорость конкретной модели: значение имеют архитектура модели, точность вычислений, параллелизм, длина контекста и программное обеспечение.
NVIDIA HGX B300: восемь ускорителей Blackwell Ultra
Сердце системы — NVIDIA HGX B300 8-GPU. Это не восемь независимых потребительских видеокарт в обычных PCIe-слотах, а связанная вычислительная платформа формата SXM с NVLink и NVSwitch. Она рассчитана на совместную работу ускорителей, когда модели и данные распределяются по нескольким GPU.
NVIDIA относит B300 к поколению Blackwell Ultra. По данным производителя, пиковая тензорная производительность всей платформы HGX B300 достигает 144 PFLOPS в FP4 при оговорённых условиях измерения, включая разреженность. Это теоретический показатель определённого типа вычислений, а не универсальная скорость сервера и не обещание заданного числа токенов в секунду. Для оценки реального инференса нужны тесты на конкретной LLM, длинах запросов и целевом времени ответа.
2,3 ТБ HBM3e: зачем AI-серверу столько видеопамяти
В спецификации Supermicro для B300 указаны 288 ГБ HBM3e на один GPU. Восемь ускорителей дают суммарно 2 304 ГБ, то есть приблизительно 2,3 ТБ. NVIDIA указывает для B300 пропускную способность памяти до 8 ТБ/с на ускоритель и до 64 ТБ/с в сумме на узел — это паспортные верхние пределы, а не гарантированная пропускная способность приложения.
Для LLM память расходуется не только на веса нейросети. Нужны пространство под KV-кэш, промежуточные тензоры, рабочие буферы и служебные структуры фреймворка. Чем длиннее контекст и выше параллельность запросов, тем важнее запас HBM. Большой объём также упрощает размещение крупных моделей без постоянного обмена с существенно более медленной системной памятью.
Нюанс: 2,3 ТБ — это сумма памяти восьми GPU, а не единая физическая память, одинаково доступная каждому ускорителю. Чтобы большая модель работала на нескольких B300, требуется распределение вычислений и данных (например, tensor parallelism) с учётом обменов между GPU. В части материалов NVIDIA также фигурирует приблизительно 2,1 ТБ доступной памяти платформы; при планировании полезной ёмкости следует ориентироваться на фактически видимую приложению память и резервы программного стека.
NVLink пятого поколения и NVSwitch: почему это важно
Когда LLM размещена сразу на нескольких GPU, ускорители должны обмениваться промежуточными результатами. В конфигурации HGX B300 эту задачу решают NVLink пятого поколения и NVSwitch. NVIDIA указывает до 1,8 ТБ/с двунаправленной пропускной способности NVLink на GPU и 14,4 ТБ/с суммарно для восьмиускорительной платформы.
На практике такой интерконнект особенно полезен при тензорном параллелизме, коллективных операциях, обучении больших моделей и вычислениях, где синхронизация GPU происходит часто. При этом NVLink не заменяет внешнюю сеть между серверами: для многоузлового кластера отдельно проектируют сетевую фабрику, топологию и транспорт данных.
Два Intel Xeon 6768P и 2 ТБ DDR5: роль процессоров
В конфигурации -01-G2 установлены два Intel Xeon 6768P с 64 физическими ядрами каждый, всего 128 ядер; заявленная базовая частота — 2,4 ГГц. CPU отвечают за управление задачами, обработку запросов, подготовку данных, работу ОС, сетевого и инфраструктурного ПО. Ускорители при этом берут на себя наиболее интенсивные матричные операции.
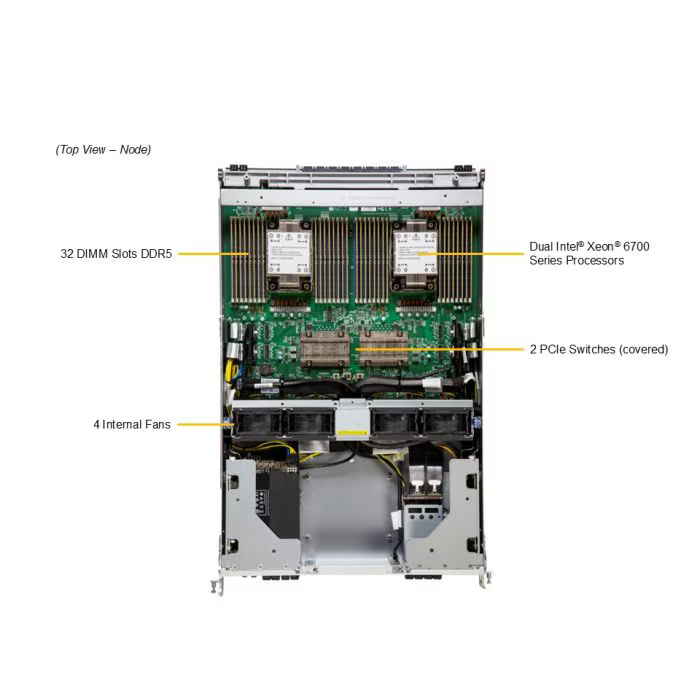
Плата двухпроцессорного узла: два процессорных сокета, группы DIMM-слотов и подсистема ввода-вывода.
Системная память — 2 ТБ DDR5-6400 ECC RDIMM, по официальной комплектации 16 × 128 ГБ. ECC важна для инфраструктуры, которая длительно работает под нагрузкой. При этом оперативная память CPU и HBM3e на GPU — разные уровни иерархии памяти: 2 ТБ DDR5 не следует прибавлять к HBM как к однородному пространству под веса модели.
ConnectX-8, сеть 800 Гбит/с и накопители
Supermicro предусматривает восемь высокоскоростных сетевых интерфейсов на базе NVIDIA ConnectX-8 SuperNIC; в документации указываются варианты сетевой конфигурации вплоть до 800 Гбит/с на порт или альтернативная конфигурация 400GbE. Для серверов, объединённых в AI-кластер, это критически важная часть архитектуры: слабая межузловая сеть может ограничить масштабирование даже при мощных GPU.
Помимо высокоскоростной фабрики, в спецификации указаны два порта 10GbE. Загрузочный накопитель готовой комплектации — M.2 NVMe SSD на 960 ГБ. Это не означает, что 960 ГБ хватит для датасетов, весов моделей и чекпойнтов: рабочее хранилище, его пропускную способность и отказоустойчивость нужно планировать отдельно. У семейства SYS-822GS-NB3RT также заявлена поддержка отсеков E1.S NVMe и двух M.2, однако фактическую комплектацию и корзины конкретного SKU следует уточнять перед заказом.
Энергопотребление, охлаждение и размещение в стойке
SYS-822GS-NB3RT-01-G2 выполнен в форм-факторе 8U; размер корпуса по паспорту — приблизительно 449 × 356 × 950 мм. Это оборудование для серверного зала, а не для офисного помещения: необходимы подходящая стойка по глубине и нагрузке, организованный воздушный поток, достаточная электрическая мощность и охлаждение.
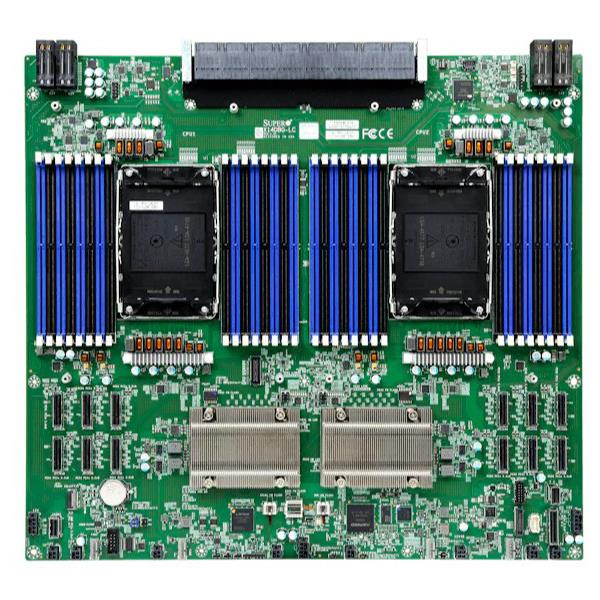
Внутренняя компоновка серверного узла: 32 слота DDR5 DIMM, два Intel Xeon серии 6700, PCIe-коммутаторы и четыре вентилятора.
Производитель указывает резервируемую подсистему питания с блоками класса Titanium и конфигурацией 3+3 по 6 600 Вт. Номиналы блоков питания нельзя складывать и считать фактическим потреблением узла. В материалах Supermicro по системам HGX B300 приводится ориентир до 15 кВт на узел при полной нагрузке; это проектная величина, которую важно уточнить для выбранной комплектации и условий эксплуатации. При таком уровне нагрузки существенную долю стоимости владения составляют энергия, охлаждение и подготовка дата-центра.
Перед внедрением стоит запросить у поставщика точную схему питания, требования к PDU и электроподключению, параметры воздуха на входе, тепловыделение, допустимую загрузку стойки и условия сервисного обслуживания. В отличие от настольной рабочей станции, здесь эксплуатационная готовность площадки — часть технического задания.
Где производительность HGX B300 раскрывается лучше всего
Корпоративный LLM-инференс
Большой объём HBM и быстрый GPU-интерконнект полезны, когда требуется обслуживать крупные языковые модели, большие контексты и поток одновременных обращений. Особенно востребованы сценарии внутренних AI-ассистентов, поиска по документам (RAG), автоматизации поддержки и агентных систем. Однако RAG сам по себе не требует восьми GPU: размер сервера должен соответствовать выбранной модели и ожидаемой нагрузке.
Дообучение и обучение нейросетей
Система подходит для исследовательских и корпоративных задач fine-tuning и распределённого обучения. Важно оценивать не только объём весов, но и память для градиентов, состояний оптимизатора и активаций. Поэтому возможность загрузить модель для инференса не означает возможность полноценно обучать её в том же объёме без дополнительной оптимизации или распределения.
Мультимодальный AI и высокопроизводительные вычисления
Обработка изображений, видео, речи и совместных текстово-визуальных моделей создаёт разные профили вычислений и передачи данных. HGX B300 интересен тем, что даёт инфраструктурный запас для нескольких типов AI-нагрузок, но реальная эффективность зависит от поддержки конкретного фреймворка и используемой числовой точности.
Плюсы и ограничения: объективная оценка
Сильные стороны
Восемь NVIDIA B300 в интегрированной HGX-платформе для крупномасштабных задач.
Большой суммарный объём HBM3e — важный ресурс для LLM с крупными весами и длинным контекстом.
NVLink и NVSwitch для ускоренного обмена между GPU внутри узла.
128 CPU-ядер и 2 ТБ ECC RAM в заранее определённой конфигурации.
Высокоскоростная сеть ConnectX-8 для интеграции в AI-фабрику или кластер.
Что нужно учитывать
Высокая стоимость приобретения и эксплуатации: сервер оправдан не для каждой AI-нагрузки.
Требовательность к дата-центру: питание, охлаждение, сеть, глубина стойки и инженерное сопровождение.
Зависимость эффективности от ПО: без оптимизации инференса дорогое оборудование может использоваться не полностью.
Сложность масштабирования: дополнительные серверы требуют продуманной сети, хранения и оркестрации.
Нет универсального показателя «токенов в секунду»: он определяется моделью и методикой тестирования.
Сравнение NVIDIA HGX B300 с HGX B200 и H200
Для предварительного выбора полезно сравнить прежде всего память и межсоединение. По справочным данным NVIDIA, один H200 SXM имеет 141 ГБ HBM3e, B200 SXM — 180 ГБ, а B300 SXM — 288 ГБ. Для восьмиускорительных узлов это приблизительно 1,1 ТБ, 1,44 ТБ и 2,3 ТБ соответственно. У B200 и B300 используется NVLink пятого поколения; поэтому отличие не стоит сводить к наличию NVLink как такового.
Платформа | HBM на GPU | HBM на 8 GPU | Для чего рассматривать |
|---|---|---|---|
HGX H200 | 141 ГБ | ≈1,1 ТБ | Существующие оптимизированные HPC/AI-пайплайны, когда возможностей памяти достаточно |
HGX B200 | 180 ГБ | ≈1,44 ТБ | Мощные Blackwell-кластеры без максимального требования к ёмкости HBM |
HGX B300 | 288 ГБ | ≈2,3 ТБ | Крупные LLM, ресурсоёмкий инференс, высокая плотность AI-вычислений |
Это сравнение платформ, а не обещание одинаковой производительности в готовых серверах. Для честного выбора важно дополнительно сопоставить стоимость узла, энергопотребление, поддержку ПО, пропускную способность внешней сети и результаты тестов на собственных моделях.
Кому подойдёт Supermicro SYS-822GS-NB3RT-01-G2
AI-провайдерам и облачным платформам: для обслуживания ресурсоёмких моделей и организации вычислительных пулов.
Крупным компаниям: для собственной инфраструктуры генеративного AI, если требования к данным, задержкам или масштабу оправдывают on-premise-развёртывание.
Исследовательским центрам: для вычислительно сложных экспериментов и обучения моделей.
Командам, создающим AI-платформы: как один из узлов высокопроизводительного кластера.
Кому не подойдёт: небольшим проектам с единичными запросами к компактным моделям, офисам без серверной инфраструктуры и компаниям, которые не рассчитали загрузку GPU. Для таких задач зачастую рациональнее меньшая конфигурация или аренда мощностей. Покупка HGX B300 имеет смысл при прогнозируемой загрузке и понятной экономике эксплуатации.
Технические характеристики Supermicro SYS-822GS-NB3RT-01-G2
Параметр | Характеристика |
|---|---|
Модель | Supermicro SYS-822GS-NB3RT-01-G2, Gold Series |
Форм-фактор | 8U, сервер для монтажа в стойку |
GPU | NVIDIA HGX B300, 8 × NVIDIA B300 Blackwell Ultra |
Память GPU | 288 ГБ HBM3e на GPU; 2 304 ГБ суммарно по спецификации Supermicro |
GPU-интерконнект | NVLink 5-го поколения и NVSwitch; до 1,8 ТБ/с на GPU (двунаправленно) |
Процессоры | 2 × Intel Xeon 6768P, по 64 ядра, базовая частота 2,4 ГГц |
ОЗУ | 2 ТБ DDR5-6400 ECC RDIMM (16 × 128 ГБ) |
Системный SSD | 1 × 960 ГБ M.2 NVMe |
Сеть | ConnectX-8 SuperNIC; скоростная конфигурация зависит от исполнения; 2 × 10GbE |
Питание | Резервируемые блоки 6600 Вт Titanium, схема 3+3 по паспорту семейства |
Охлаждение | Воздушное, до 12 высокопроизводительных вентиляторов |
Размеры корпуса | 449 × 356 × 950 мм (по паспорту Supermicro) |
Назначение | LLM-инференс, генеративный AI, обучение, HPC |
Примечание: спецификации производителей могут обновляться; параметры сети, хранения, электроподключения и комплект поставки следует подтвердить по коммерческой спецификации конкретного SKU.
Цена Supermicro SYS-822GS-NB3RT-01-G2 и где купить
Сервер Supermicro SYS-822GS-NB3RT-01-G2 представлен в каталоге imaxstore. На момент подготовки обзора в карточке указана цена 130 014 150 ₽, при этом магазин отдельно рекомендует уточнять актуальную стоимость и наличие у менеджера. Для оборудования такого класса важно согласовать не только цену системы, но и условия поставки, гарантию, сервис на площадке, сеть, монтаж и интеграцию с существующей инфраструктурой.
Перед согласованием закупки полезно направить поставщику требования к моделям, длине контекста, одновременным пользователям, времени ответа, планируемому росту нагрузки и условиям дата-центра. По этим данным легче определить, подходит ли готовая конфигурация или необходим другой вариант AI-сервера.
Частые вопросы о Supermicro SYS-822GS-NB3RT-01-G2
Сколько GPU в Supermicro SYS-822GS-NB3RT-01-G2?
В системе установлена платформа NVIDIA HGX B300 с восемью ускорителями B300, объединёнными через NVLink и NVSwitch.
Сколько видеопамяти у NVIDIA HGX B300 8-GPU?
По спецификации Supermicro — 288 ГБ HBM3e на GPU, суммарно 2 304 ГБ. Память физически распределена между ускорителями, поэтому полезный объём для конкретного приложения зависит от его распределённой архитектуры.
Подходит ли сервер для запуска больших языковых моделей?
Да. Платформа ориентирована на крупные LLM и высоконагруженный инференс, но совместимость и производительность определяются размером модели, точностью вычислений, длиной контекста и программным стеком.
Можно ли обучать нейросети на этом сервере?
Да, оборудование поддерживает обучение и дообучение AI-моделей. Необходимые ресурсы зависят от модели, оптимизатора, размера батча и выбранной схемы распределённых вычислений.
Чем HGX B300 отличается от HGX B200?
Одно из ключевых отличий — больший объём HBM3e: 288 ГБ на B300 против 180 ГБ на B200 по сравнительным данным NVIDIA. Это особенно важно для ёмких моделей и KV-кэша; конечную производительность нужно сравнивать на реальных задачах.
Нужна ли специальная серверная для SYS-822GS-NB3RT-01-G2?
Да. Это 8U-сервер с высокими требованиями к электропитанию, охлаждению, стойке и сети. Перед установкой необходима проверка инженерных условий дата-центра.
Можно ли использовать все 2,3 ТБ HBM как единую память?
Нет. Это сумма памяти восьми отдельных GPU. Программное обеспечение может распределять модель между ними, но архитектуру межGPU-обмена и служебные резервы нужно учитывать отдельно.
Итог: стоит ли выбирать Supermicro с NVIDIA HGX B300?
Supermicro SYS-822GS-NB3RT-01-G2 — профессиональная платформа для организаций, которым требуется большая ёмкость HBM, быстрый обмен между восемью GPU и готовая основа для масштабируемых AI-сервисов. Её сильная сторона — не отдельная рекордная цифра, а сочетание ускорителей Blackwell Ultra, NVLink, серверной памяти, CPU и высокоскоростной сети в одной системе.
При этом покупка оправдана только после оценки реальной нагрузки и инфраструктуры. Если задача — обслуживать крупные языковые модели, строить собственную AI-фабрику или обучать ресурсоёмкие нейросети, HGX B300 заслуживает внимания. Если же нагрузка невелика или нестабильна, разумно сначала сравнить стоимость владения с альтернативными GPU-серверами и облачными вычислениями.
Подробнее: характеристики, комплектация и условия покупки Supermicro SYS-822GS-NB3RT-01-G2 в imaxstore.
Источники и документация
Больше обзоров
Подписывайтесь, чтобы не пропустить новые видео и распаковки.
Другие статьи
Почему Apple 7 лет ждала со складным iPhone — история iPhone Duo
Почему Apple выпустила складной iPhone только в 2026 году? От патентов и проблем первого Galaxy Fold до титанового шарнира, гибкого OLED и iOS 27: история технологий iPhone Duo, факты и ограничения первого поколения.
Читать статью
CurrentBody LED Hair Helmet & Series 3 Face & Neck: экспертный обзор набора
Три устройства для LED-ухода в одном наборе CurrentBody: шлем для волос, маска Series 3 для лица и маска для шеи. Разбираем 6 длин волн, MyDose, исследования эффективности, противопоказания и выбор комплектации.
Читать статью
AMD Ryzen AI Halo 128 ГБ / 2 ТБ: честный обзор мини-ПК для локального ИИ
AMD Ryzen AI Halo — компактная рабочая станция с Ryzen AI Max+ 395, 128 ГБ объединённой памяти и SSD 2 ТБ. Разбираем запуск локальных LLM, ROCm, реальные ограничения, сравнение с DGX Spark и Mac Studio и то, кому она подойдёт.
Читать статью